
Keď je zraniteľnosť už aktívne zneužívaná: čo rozhodnúť v prvých 48hodinách
Váš bezpečnostný tím dostane upozornenie: kritická zraniteľnosť v produkte, ktorý možno používate, je už aktívne zneužívaná.
Nie teoreticky. Nie ako vzdialené riziko. Niekde vo svete už prebiehajú útoky a vy zatiaľ neviete, či sa týkajú aj vášho prostredia.
Čo teraz? Patchovať, overovať možný prienik, izolovať systém, alebo ho dočasne vypnúť?
Prvá reakcia býva prirodzená: rýchlo nasadiť patch. Lenže pri aktívne zneužívanej zraniteľnosti nemusí byť najdôležitejšou otázkou iba to, či patch existuje. Dôležitejšie je najprv zistiť, či organizácia rieši ešte zraniteľnosť, alebo už možný incident.
Práve tento rozdiel rozhoduje o tom, či tím spúšťa vulnerability management, alebo incident response. Nasledujúci rámec pomáha CISO, IT manažérom a bezpečnostným tímom rozhodnúť sa pod tlakom medzi patchovaním, izoláciou, monitoringom a eskaláciou.
Prvá otázka nie je „máme patch?“, ale „sme vôbec zasiahnutí?“
Skôr než organizácia začne plánovať patchovanie, potrebuje rýchlo potvrdiť tri veci. Má daný produkt a zraniteľnú verziu naozaj nasadenú, nielen v produkcii, ale aj v stagingu, testovacích inštanciách, prostrediach dcérskych spoločností alebo v shadow IT? Je dotknutá inštancia dostupná z internetu, alebo je ukrytá v segmentovanej internej sieti? A kto je technickým aj biznisovým vlastníkom systému s mandátom rozhodnúť o obmedzení alebo odstavení?
Tieto otázky znejú jednoducho, no v praxi bývajú prvým slabým miestom. Organizácie s neúplným prehľadom aktív, CMDB alebo asset inventory často strávia prvé hodiny zisťovaním, či sa ich problém vôbec týka. Ak neviete do jednej hodiny potvrdiť alebo vylúčiť, že máte dotknutý produkt a expozíciu, je to samo osebe zistenie. Ponaučením má byť aj investícia do asset managementu a externého attack surface monitoringu.
Preto by prvý telefonát alebo ticket nemal smerovať len k naplánovaniu patch okna. Mal by súčasne zapojiť vlastníka infraštruktúry aj bezpečnostný tím a odpovedať na otázku: vieme potvrdiť alebo vylúčiť prítomnosť, expozíciu a biznis kontext dotknutého systému?
Dva rôzne signály, dve rôzne reakcie
Informácia, že sa zraniteľnosť masovo zneužíva vo svete, je impulzom pre vulnerability management. Znamená to, že riziko výrazne stúplo a patchovanie alebo kompenzačné opatrenie má dostať prioritu. Neznamená to však automaticky, že organizácia už bola napadnutá.
Iný typ signálu je konkrétny dôkaz pokusu alebo úspešného zneužitia vo vašom prostredí: zhoda s IOC v logoch, anomálny proces, neočakávané odchádzajúce spojenie, nový účet alebo naplánovaná úloha, ktorú nikto legitímne nezaložil. Vtedy už nejde len o riadenie zraniteľnosti, ale o incident response.
Toto rozlíšenie je kritické. Patch môže uzavrieť vstupné dvere, neodstraňuje však útočníka, ktorý sa cez ne mohol dostať skôr a môže mať zabezpečenú perzistenciu. Ak bol systém zraniteľný v čase, keď sa exploit už verejne používal, samotné patchovanie nestačí. Treba overiť, nie predpokladať, že k zneužitiu nedošlo.
Ticho v monitoringu nie je dôkaz bezpečia
Ak SOC alebo interný monitoring nehlási žiadny alert, ešte to automaticky neznamená, že je organizácia v poriadku. Monitoring je len taký dobrý, aká je hĺbka a retencia logov, a aké detekčné pravidlá existovali predtým, než sa o zraniteľnosti vedelo.
Problém nastáva najmä tam, kde chýba logovanie príkazového riadku, vytvárania procesov, sieťových spojení na úrovni aplikácie alebo kde je retencia logov kratšia než obdobie medzi zverejnením exploitu a nasadením patchu.
Preto nestačí opýtať sa: „Videli sme niečo podozrivé?“ Ďalšia otázka má znieť: „Mali sme vôbec šancu to vidieť?“ Ak odpoveď nie je jasná, k systému sa treba správať opatrnejšie, akoby ste o jeho stave zatiaľ nevedeli dosť.
Prvých 48 hodín: praktická os rozhodovania
1. Triage
Cieľom triage nie je vyriešiť všetko. Cieľom je rýchlo získať dosť informácií na rozhodnutie. Tím má potvrdiť prítomnosť zraniteľného produktu a všetkých jeho inštancií, zistiť expozíciu, doplniť biznis kontext, skontrolovať dostupné IOC a detekčné signatúry, určiť vlastníka rozhodnutia a otvoriť interný ticket s
2. Rozhodnutie a prvá akcia
Na základe zistení tím rozhoduje o kombinácii opatrení: patchovanie, izolácia, kompenzačné kontroly alebo eskalácia na incident response. Tieto možnosti sa nevylučujú. V reálnych prípadoch sa často kombinujú.
Ak sa objaví čo i len jeden náznak kompromitácie, eskalácia na incident response má prebehnúť okamžite. Zachovanie dôkazov, logov, snapshotov a pamäte má prednosť pred rýchlym upratovaním. Súčasne má prebehnúť komunikácia smerom k vedeniu a biznis vlastníkom, pretože odstavenie produkčného systému je bezpečnostné aj prevádzkové rozhodnutie. Ak môže ísť o dopad na osobné údaje alebo oznamovacie povinnosti, DPO alebo právne oddelenie nemá byť zapojené až na konci.
3. Exekúcia, overenie a komunikácia
Po nasadení opatrenia nestačí konštatovať, že patch bol nainštalovaný. Treba overiť, že cesta útoku je skutočne uzavretá. Súčasťou má byť aj zvýšený, cielený monitoring dotknutého systému počas nasledujúcich dní až týždňov, rozhodnutie o externej komunikácii, ak je relevantná, a stručná časová os rozhodnutí pre neskoršie poučenie.
Rozhodovacia matica: patchovať, izolovať, monitorovať alebo eskalovať
Pod tlakom pomáhajú konkrétne kritériá. Tabuľku je možné použiť ako rýchly rámec, nie ako automatický výpočet rizika.
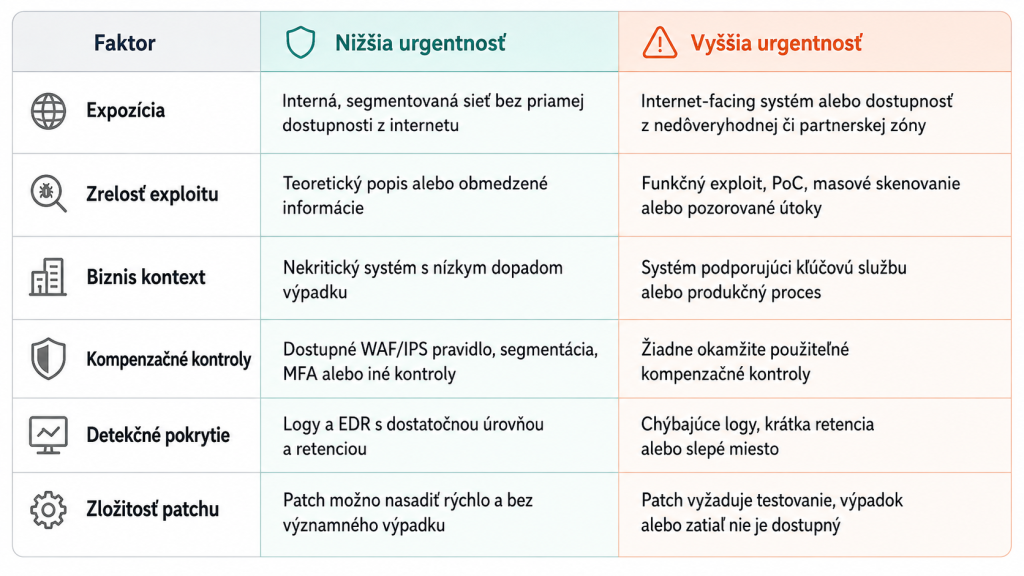
Z kombinácie týchto faktorov vyplývajú typické scenáre. Patchovanie môže stačiť pri segmentovanom systéme bez indikátorov kompromitácie, ak je patch dostupný v rozumnom čase. Patchovanie spolu s dočasnou izoláciou alebo obmedzením prístupu dáva zmysel pri exponovanom systéme, kde patch nemožno nasadiť okamžite. Monitoring má byť doplnok, nikdy nie samostatná odpoveď, a iba tam, kde existuje reálna telemetria.
Okamžitá eskalácia na incident response je namieste pri potvrdenom IOC hite, anomálnom správaní systému alebo pri situácii, keď bol systém preukázateľne exponovaný počas aktívnej exploitácie a zároveň chýbajú logy na vylúčenie kompromitácie. Pri absencii dôkazov v tejto fáze nie je bezpečné automaticky predpokladať, že je všetko v poriadku.
Keď patch nie je možné nasadiť hneď
Dôvody môžu byť legitímne: legacy systém, závislosť na inej aplikácii, potreba testovania alebo prevádzkové okno. Vtedy nastupujú dočasné kompenzačné opatrenia.
- virtuálne patchovanie cez WAF, NGFW alebo EDR, ak existuje použiteľná signatúra,
- dočasné ACL alebo firewall pravidlo, prípadne presun prístupu za VPN,
- obmedzenie alebo vypnutie zraniteľného modulu, ak nie je nevyhnutný pre chod systému,
- sprísnenie aplikačnej izolácie alebo mechanizmov Mandatory Access Control, ak ich systém podporuje,
- doplnenie MFA alebo zúženie oprávnení servisného účtu podľa princípu least privilege,
- cielené rozšírené logovanie a detekčné pravidlá pre konkrétnu zraniteľnosť,
- zálohovanie alebo snapshot pred zmenou, aby bolo možné neskôr forenzne porovnať stav pred a po. Dočasné opatrenie musí mať vlastníka a termín opätovného preskúmania. Inak sa z neho stane trvalá výnimka, na ktorú organizácia o pár mesiacov zabudne. Úloha SOC alebo MDR tímu v prvých 48 hodinách V tejto fáze nejde len o sledovanie alertov. Interný SOC alebo externý SOC/MDR partner pomáha organizácii zistiť, či má vôbec dostatok dôkazov na bezpečné rozhodnutie. Prakticky to znamená najmä:
- rýchlo nasadiť alebo overiť detekčné pravidlá pre konkrétnu zraniteľnosť,
- spätne prehľadať logy z obdobia, keď mohol byť systém zraniteľný a exponovaný,
- korelovať údaje z EDR, firewallov, autentifikačných logov a DNS,
- zabezpečiť eskalačnú kapacitu mimo pracovnej doby,
- priniesť nezávislé druhé posúdenie v situácii, keď je interný tím pod časovým tlakom. Najväčšia praktická hodnota SOC/MDR spolupráce vzniká najmä tam, kde organizácia nemá vlastnú 24/7 kapacitu alebo potrebuje spätne overiť, či sa útok neodohral ešte pred nasadením patchu.
Praktický checklist pre prvých 48 hodín
1.Triage
✓ Potvrdiť alebo vylúčiť dotknutý produkt a zraniteľnú verziu, vrátane stagingu, shadow IT a IT/OT prostredia.
✓ Zistiť expozíciu: internet-facing alebo segmentovaná interná sieť.
✓ Skontrolovať dostupné IOC a signatúry.
✓ Určiť vlastníka rozhodnutia a mandát na zásah. ☐ Otvoriť interný ticket s časovou pečiatkou zistenia.
2. Rozhodnutie a prvá akcia
✓ Vyhodnotiť situáciu podľa matice: patchovanie, izolácia, kompenzačné opatrenie alebo eskalácia.
✓ Pri akomkoľvek náznaku kompromitácie eskalovať na incident response a zachovať dôkazy.
✓ Informovať vedenie a biznis vlastníkov dotknutých systémov.
✓ Ak je to relevantné, zapojiť DPO alebo právne oddelenie paralelne s technickým riešením.
3. Exekúcia a overenie
✓ Nasadiť zvolené opatrenie.
✓ Overiť, že cesta útoku je skutočne uzavretá.
✓ Nastaviť zvýšený monitoring na nasledujúce dni až týždne.
✓ Rozhodnúť o externej komunikácii v prípade incidentu, ak je relevantná. ☐ Zaznamenať stručnú časovú os rozhodnutí pre lessons learned.
Záver
Prvých 48 hodín nie je súťaž v rýchlosti patchovania. Je to postupnosť rozhodnutí s neúplnými informáciami. Najdrahšia chyba nemusí byť pomalý patch, ale nesprávne položená otázka.
Organizácie, ktoré túto fázu zvládajú dobre, majú rozdiel medzi „riešime zraniteľnosť“ a „riešime možný incident“ vyriešený vopred, v procesoch a eskalačných maticiach. Neimprovizujú, keď už čas beží.
Práve v budovaní a testovaní tejto pripravenosti, a v poskytovaní 24/7 kapacity na spätné overenie a eskaláciu, spočíva praktická hodnota SOC/MDR spolupráce pre organizácie, ktoré takúto kapacitu interne nemajú.
Vypočujte si viac od našich rečníkov
Pridajte sa na Qubit Conference® Slovensko 2026 - 11. - 12. novembra
Súvisiace články

Kde končí transparentnosť a začína zásah do súkromia?
Ján Golais · 9 min čítania
Kybernetická odolnosť v období technologickej a geopolitickej neistoty
Ing. Martin Pavelka · 6 min čítania
NIS2 v praxi: pohľad z výrobného priemyslu
Lucia Žvačeková · 7 min čítania